
Ассистент на основе ИИ для анализа, верификации и валидации производственной мастер-спецификации (Master BOM)
Перевод на русский язык
ЛАБОРАТОРИЯ ARC: физический ИИ и интеллектуальное производство
IB-ARC — проект на промышленной основе
Идентификатор проекта ARC [ARC-IB-2608-01]
Название статьи | Ассистент на основе ИИ для анализа, верификации и валидации производственной | ||||||
|---|---|---|---|---|---|---|---|
мастер-спецификации (Master BOM) | |||||||
Руководитель проекта: Narbeh Nahapetian | Авторы (в порядке публикации): Ashot Arzumanian |
Основная информация о проекте | |||
|---|---|---|---|
Дата представления первичного предложения: | Дата представления статьи: | ||
Категория ARC: □ EB-ARC ☑ IB-ARC □ RB-ARC | Продолжительность: | ||
Спонсоры (если есть): - | Имеющиеся активы проекта: ☑ Да □ Нет | ||
Члены команды: Ashot Arzumanian | Разработан POC: ☑ Да □ Нет | ||
Тип проекта: ☑ Улучшение процессов □ Автоматизация ☑ ИИ/МО □ Производство □ Робототехника □ Гибридный □ Встраиваемые системы ☑ Закупки |
Аннотация
Производственные мастер-спецификации (BOM) являются основой современного производства, закупок и управления запасами. Однако несоответствия между артикулами производителя (MPN) и соответствующими описаниями компонентов часто возникают из-за ручного ввода данных, неполной документации или человеческой ошибки. Такие несоответствия могут приводить к неправильному выбору компонентов, увеличению трудозатрат на инженерную проверку, задержкам в закупках и снижению качества данных на протяжении всего производственного процесса.
В данном проекте представлены проектирование, разработка и валидация агента проверки на основе ИИ, способного автоматически определять, соответствует ли описание компонента компоненту, идентифицированному его артикулом производителя. Разработанная система относит каждую пару «MPN — описание» к одной из трёх категорий: Match (соответствие), Partial Match (частичное соответствие) или No Match (несоответствие), что позволяет инженерам быстро выявлять неверные или неполные записи BOM и одновременно способствует стандартизации описаний компонентов.
Решение было реализовано в виде проверки концепции с использованием агента ИИ, разработанного на платформе автоматизации n8n, где в качестве механизма рассуждений служат большие языковые модели (LLM) на основе GPT. Был создан полный рабочий процесс для получения пар «MPN — описание», выполнения анализа на основе ИИ, измерения производительности выполнения и возврата результатов проверки через пользовательский интерфейс на базе Excel. Для оценки системы в реалистичных производственных сценариях был подготовлен структурированный проверочный набор данных, состоящий из репрезентативных компонентов с намеренно изменёнными описаниями.
Значительная часть исследования была посвящена проектированию промптов (prompt engineering), а не дообучению модели. Несколько версий промптов были систематически разработаны, протестированы и доработаны путём изменения инструкций по рассуждению, правил принятия решений, ограничений вывода, логики сравнения и параметров модели. В ходе экспериментальной оценки сравнивались различные модели GPT и
стратегии промптов, что показало, как тщательно структурированные промпты существенно повышают согласованность, качество рассуждений, надёжность вывода и точность классификации, одновременно снижая вариативность ответов.
Готовая система демонстрирует, что современные LLM могут эффективно поддерживать интеллектуальную проверку BOM без необходимости обучения модели в конкретной предметной области. Проект устанавливает практическую методологию интеграции агентов ИИ в инженерные рабочие процессы и создаёт основу для будущих расширений, включая автоматическое формирование описаний, стандартизацию компонентов, интеграцию с MRP (планированием потребностей в материалах) и более широкую проверку производственных данных с помощью ИИ.
Ключевые слова
Искусственный интеллект (ИИ), большие языковые модели (LLM), GPT, проектирование промптов, спецификация материалов (BOM), артикул производителя (MPN), проверка описаний, верификация данных, интеллектуальное производство, автоматизация производства, агент ИИ, n8n, качество инженерных данных.
Резюме
Производственные мастер-спецификации (BOM) служат основой производства, определяя каждый компонент, необходимый для изготовления изделия. Точность данных BOM напрямую влияет на проектирование, закупки, управление запасами, планирование производства и качество продукции. Одной из наиболее распространённых проблем качества данных является несоответствие между артикулом производителя (MPN) и соответствующим описанием компонента. Такие несоответствия могут возникать из-за ручного ввода данных, неполной документации, копирования описаний похожих компонентов или простой человеческой ошибки. Хотя эти ошибки могут казаться незначительными, они могут увеличивать трудозатраты на инженерную проверку, усложнять процессы закупок и создавать риск выбора неправильных компонентов.
Целью проекта было спроектировать, разработать и проверить агента проверки на основе ИИ, способного автоматически анализировать соответствие между артикулами производителя (MPN) и соответствующими описаниями компонентов в производственных мастер-спецификациях. Вместо того чтобы полагаться на вручную разработанные правила проверки для тысяч различных семейств компонентов, предлагаемое решение использует способности к рассуждению больших языковых моделей (LLM) на основе GPT для анализа характеристик, связанных с артикулом производителя, и их сравнения с предоставленным описанием.
Агент проверки на основе ИИ в виде проверки концепции был спроектирован и разработан на платформе автоматизации n8n. Для агента ИИ использовались языковые модели на основе GPT. Данные (пары «артикул производителя — описание» для практического примера, проверочные данные, примечания, история) хранились в Google Sheets. Интерфейс Excel предназначен для инженерного использования. Система принимает на вход MPN и соответствующее описание, определяет характеристики указанного компонента, сравнивает эти характеристики с предоставленным описанием и классифицирует пару как Match, Partial Match или No Match.
Исследование было сосредоточено прежде всего на проектировании промптов и систематической оптимизации рассуждений ИИ. Вместо того чтобы рассматривать языковую модель как фиксированное решение, было разработано, экспериментально оценено и итеративно доработано несколько версий промптов. Каждая итерация вносила изменения в инструкции по рассуждению, правила сравнения, ограничения вывода, логику принятия решений и параметры модели. Производительность измерялась с помощью контролируемого проверочного набора данных, содержащего репрезентативные пары «MPN — описание» — от полностью правильных до намеренно неполных и неверных. Эта итеративная методология позволила выявить структуры промптов, которые значительно повысили согласованность рассуждений, снизили вариативность вывода и увеличили надёжность классификации.
Завершённый проект демонстрирует, что современные LLM могут эффективно помогать в задачах инженерной проверки и в общем развитии интеллектуального производства без необходимости специального обучения модели. Помимо разработанной проверки концепции, проект устанавливает практическую методологию проектирования агентов ИИ, способных проверять инженерные данные в производственной среде. Представленный подход может служить основой для будущей интеграции с системами планирования потребностей в материалах (MRP), автоматического формирования описаний, стандартизации BOM и более широкой проверки производственных данных с помощью ИИ.
Определение промышленной проблемы
Каждая запись BOM обычно содержит артикул производителя (MPN), однозначно идентифицирующий компонент, поставляемый производителем, а также текстовое описание, кратко излагающее его наиболее важные характеристики. Инженеры, специалисты по закупкам, производственный персонал, менеджеры по запасам и другие заинтересованные стороны опираются на оба этих элемента информации на протяжении всего жизненного цикла изделия.
На практике соответствие между MPN и его описанием не всегда может быть гарантировано. Описания компонентов часто вводятся вручную, копируются из предыдущих проектов, сокращаются для удобства или изменяются без полной проверки. В результате в описаниях могут отсутствовать важные характеристики, содержаться устаревшие сведения или даже описываться иной компонент, чем указанный артикулом. Эти несоответствия снижают качество инженерных данных, увеличивают вероятность человеческой ошибки и требуют дополнительной ручной проверки, прежде чем можно будет продолжить закупочную или производственную деятельность.
Традиционные методы проверки в основном ручные и требуют от инженеров поиска документации производителя или технических баз данных, чтобы сравнить характеристики, связанные с MPN, с его письменным описанием. Этот процесс однообразен, занимает много времени и становится всё более непрактичным по мере того, как производственные мастер-спецификации разрастаются до сотен или тысяч компонентов. Кроме того, обычное программное обеспечение проверки на основе правил сложно разрабатывать и поддерживать, поскольку разные категории компонентов имеют разные структуры характеристик, соглашения об именовании и форматы описаний. Разработка детерминированных правил проверки, охватывающих все возможные типы компонентов, требует значительных инженерных усилий и постоянного сопровождения.
Последние достижения в области больших языковых моделей (LLM) предлагают альтернативный подход. В отличие от традиционных систем на основе правил, LLM способны понимать технический язык, извлекать нужные характеристики из технических источников, сопоставлять контекстную информацию и рассуждать применительно к самым разным категориям компонентов. Это создаёт возможность автоматизировать значительную часть проверки BOM, сохраняя гибкость в отношении различных производителей, семейств компонентов и стилей описаний.
Промышленная проблема, которую решает данный проект, — автоматическая проверка соответствия между артикулами производителя и соответствующими описаниями в производственных мастер-спецификациях. Искомое решение должно надёжно различать три ситуации: описания, которые правильно представляют указанный компонент (Match); описания, которые не содержат противоречащей информации, но требуют дополнительной детализации (Partial Match); и описания, содержащие одну или несколько противоречащих характеристик (No Match). Помимо точной классификации, решение должно выдавать детерминированные результаты, сводить к минимуму вариативность ответов, сохранять разумные время выполнения и эксплуатационные затраты и оставаться достаточно универсальным, чтобы поддерживать широкий спектр категорий компонентов без программирования под конкретные компоненты.
Успешное решение этой проблемы может сократить трудозатраты на инженерную проверку, повысить качество данных BOM, поддержать процессы закупок, способствовать стандартизации описаний компонентов и заложить основу для более интеллектуальных производственных систем с поддержкой ИИ.
Существующее положение / предпосылки и текущее состояние
Производственные мастер-спецификации (BOM) — важнейшие инженерные документы, используемые на протяжении всего производственного жизненного цикла. Они определяют компоненты, необходимые для изготовления изделия, и служат общим источником информации для проектирования, закупок, управления запасами, планирования производства и обеспечения качества. Каждая запись BOM обычно включает артикул производителя (MPN) вместе с текстовым описанием, кратко излагающим основные характеристики компонента. Поддержание соответствия между этими двумя полями необходимо для обеспечения надёжности инженерных данных и эффективности производственных операций.
Во многих производственных организациях проверка данных BOM остаётся в основном ручным процессом. Инженеры и специалисты по закупкам сравнивают артикулы производителя с каталогами поставщиков, техническими базами данных или документацией производителя, чтобы подтвердить, что записанное описание точно представляет указанный компонент. При выявлении несоответствий или неполных описаний их необходимо исправить вручную, прежде чем BOM можно будет уверенно использовать в последующих процессах. Хотя этот подход эффективен для небольших наборов данных, он становится всё более трудоёмким и ресурсозатратным по мере роста объёма и сложности производственных мастер-спецификаций.
Для улучшения управления BOM были разработаны различные программные решения, предоставляющие такие функции, как обнаружение дубликатов, стандартизация данных, управление жизненным циклом и интеграция с системами планирования ресурсов предприятия (ERP) и планирования потребностей в материалах (MRP). Однако эти системы, как правило, зависят от структурированных баз данных, заранее заданных правил проверки или точного совпадения полей. Будучи подходящими для детерминированных задач проверки, они часто имеют ограниченные возможности для рассуждения о смысловой связи между артикулом производителя и описанием компонента в свободной форме, особенно когда описания неполны, сокращены или написаны с использованием иной терминологии.
Традиционно расширение автоматической проверки требовало разработки систем на основе правил, явно определяющих, как следует анализировать различные категории компонентов. Такие системы обычно требуют значительных инженерных усилий, поскольку каждое семейство компонентов может иметь разные наборы характеристик, соглашения об именовании и форматы
описаний. По мере появления новых производителей, изделий и стилей описаний эти правила необходимо постоянно обновлять и сопровождать, из-за чего подход становится всё труднее масштабировать.
Последние достижения в области искусственного интеллекта, в частности больших языковых моделей (LLM), открыли новые возможности для проверки инженерных данных. В отличие от традиционных подходов на основе правил, LLM способны интерпретировать технический язык, понимать контекстные связи, извлекать нужные характеристики и рассуждать о том, описывают ли два элемента информации один и тот же физический компонент. Эти возможности позволяют системам ИИ выполнять задачи проверки, которые иначе потребовали бы множества вручную заданных правил, оставаясь при этом адаптируемыми к различным категориям компонентов и стилям описаний.
Несмотря на эти достижения, применение LLM в производственной среде сопряжено с рядом практических трудностей. Модели ИИ могут давать несогласованные ответы, по-разному интерпретировать технические характеристики при разных запусках, галлюцинировать или формировать выходные данные, не соответствующие строгим форматам, которых требуют автоматизированные рабочие процессы. Кроме того, при интеграции LLM в промышленные процессы важное значение приобретают время отклика, эксплуатационные затраты, сложность промптов и надёжность рассуждений. Поэтому успешная реализация требует не только выбора подходящей языковой модели, но и проектирования детерминированных рабочих процессов, тщательно продуманных промптов и строгих методик проверки для обеспечения надёжной работы.
Настоящий проект решает эти задачи путём разработки агента проверки на основе ИИ, специально предназначенного для валидации производственной мастер-спецификации. Вместо того чтобы полагаться на обширное программирование под конкретные компоненты, предлагаемое решение использует систематическое проектирование промптов и контролируемое проектирование рабочего процесса для получения надёжных классификаций Match, Partial Match и No Match. Таким образом, в проекте исследуется, как современные LLM могут быть превращены из языковых моделей общего назначения в надёжных инженерных ассистентов, способных поддерживать проверку BOM в производственной среде.
Цели проекта
Основной целью проекта было спроектировать, разработать и проверить агента проверки на основе ИИ, способного автоматически анализировать соответствие между артикулами производителя (MPN) и соответствующими описаниями компонентов в производственных мастер-спецификациях. Предлагаемая система должна была заменить ручные трудозатраты на проверку, выявляя неверные, неполные или несогласованные записи BOM и одновременно способствуя стандартизации описаний компонентов.
Для достижения этой цели проект был сосредоточен на следующих задачах:
• Спроектировать агента ИИ в виде проверки концепции, способного принимать на вход MPN и соответствующее описание и автоматически определять, точно ли описание представляет указанный компонент. • Разработать согласованную и надёжную методику классификации, относящую каждую пару «MPN — описание» к одному из трёх заранее определённых результатов: Match, Partial Match или No Match. • Исследовать методы проектирования промптов, улучшающие способности к рассуждению, согласованность и надёжность больших языковых моделей на основе GPT при выполнении задач технической инженерной проверки. • Оценить различные версии промптов, стратегии рассуждения и конфигурации моделей с помощью контролируемого проверочного набора данных, чтобы определить наиболее надёжное решение. • На протяжении всего процесса разработки проекта добиваться детерминированных результатов, сохраняя приемлемое время выполнения и практичные эксплуатационные затраты, чтобы сделать применение больших языковых моделей для проверки инженерных данных целесообразным.
Общая цель заключалась не только в разработке работающей проверки концепции, но и в создании структурированной методологии проектирования агентов ИИ, способных поддерживать процессы инженерной проверки в среде интеллектуального производства.
Определение требований
Требования к предлагаемому агенту проверки на основе ИИ были выведены непосредственно из промышленной проблемы, определённой в предыдущих разделах. Поскольку целью проекта была разработка проверки концепции, способной поддерживать проверку производственной мастер-спецификации, система должна была не только выполнять требуемую задачу проверки, но и давать надёжные, воспроизводимые и практически применимые результаты, подходящие для инженерной среды. Определённые требования направляли как архитектуру решения, так и итеративный процесс проектирования промптов на протяжении всего проекта.
Функциональные требования
Система должна:
• Принимать в качестве основных входных данных артикул производителя (MPN) вместе с соответствующим описанием компонента. • Определять характеристики, связанные с предоставленным MPN, не изменяя и не декодируя исходный идентификатор производителя. • Сравнивать извлечённые характеристики компонента с предоставленным описанием и оценивать их соответствие. • Относить каждую проанализированную пару «MPN — описание» ровно к одной из трёх заранее определённых категорий:
o Match — описание правильно представляет указанный компонент. o Partial Match — описание не содержит противоречащей информации, но требует дальнейшего дополнения или дополнительной детализации. o No Match — одна или несколько характеристик противоречат компоненту, идентифицированному по MPN. • Возвращать классификацию в детерминированном формате вывода, пригодном для дальнейшей автоматизированной обработки. • Обрабатывать несколько пар «MPN — описание» в рамках автоматизированного рабочего процесса без необходимости ручного вмешательства во время выполнения.
Нефункциональные требования
Система должна:
Помимо требуемой функциональности, от системы ожидалось выполнение ряда требований к качеству, необходимых для практического промышленного использования.
Процесс проверки должен давать согласованные и надёжные классификации, сводя к минимуму излишнюю вариативность вывода при многократном анализе одинаковых входных данных. Хотя большие языковые модели по своей природе вероятностны, разработанная методология проектирования промптов должна обеспечивать, чтобы сформированные классификации оставались стабильными и находились в пределах заранее определённых приемлемых с инженерной точки зрения результатов.
Решение должно сохранять разумное время выполнения, чтобы проверку можно было эффективно выполнять для больших производственных мастер-спецификаций, не внося чрезмерных задержек в инженерные рабочие процессы.
Ещё одним важным соображением была эксплуатационная эффективность. Рабочий процесс должен сводить к минимуму расход токенов и затраты на API при сохранении качества проверки, что делает решение экономически пригодным для многократного промышленного использования.
Разработанная архитектура должна оставаться универсальной и масштабируемой, позволяя применять одну и ту же методологию проверки к различным категориям компонентов без необходимости вручную разрабатывать правила проверки для каждой категории.
Наконец, решение должно использовать модульную архитектуру рабочего процесса, позволяющую изменять или заменять отдельные компоненты — включая промпты, модели ИИ, источники входных данных и механизмы вывода — независимо друг от друга по мере внесения будущих улучшений.
Требования к исследованию
Помимо разработки работающей системы проверки, проект был направлен на определение наиболее эффективного подхода к проверке BOM на основе ИИ. Поэтому разработанная методология должна была поддерживать систематическое тестирование различных версий промптов, стратегий рассуждения и моделей GPT.
Каждое решение оценивалось на одном и том же проверочном наборе данных, что позволяло сравнивать точность классификации, согласованность ответов, время выполнения и эксплуатационную эффективность в одинаковых условиях. Этот итеративный процесс оценки гарантировал, что итоговый агент проверки был разработан путём структурированной оптимизации и экспериментальной проверки, а не на основе единственной реализации промпта.
Предлагаемое решение
Предлагаемое решение — это ассистент проверки на основе ИИ, предназначенный для автоматического анализа соответствия между артикулами производителя (MPN) и соответствующими описаниями компонентов в производственных мастер-спецификациях материалов (BOM). Основное назначение системы — поддерживать инженеров при подготовке и проверке BOM, выявляя несогласованные, неполные или неверные описания и сокращая объём необходимой ручной проверки. Это непосредственно отвечает цели проекта — разработать интеллектуального ассистента для анализа, верификации и валидации данных производственной мастер-спецификации.
В отличие от традиционных систем проверки на основе правил, предлагаемое решение использует способности к рассуждению больших языковых моделей (LLM). Вместо ручного создания и сопровождения правил проверки для тысяч различных семейств компонентов система интерпретирует техническую информацию, связанную с артикулом производителя, и определяет, точно ли предоставленное описание представляет указанный компонент. Это позволяет применять единую методологию проверки к широкому спектру категорий компонентов без программирования под конкретные компоненты.
Процесс проверки реализован как последовательный рабочий процесс ИИ из двух агентов, в котором каждый агент отвечает за отдельную задачу рассуждения. Первый агент ИИ отвечает за извлечение и структурирование технических характеристик, связанных с переданным артикулом производителя. Используя надёжные технические источники, он формирует каноническое представление компонента, которое служит эталонным набором характеристик для процесса проверки.
Второй агент ИИ получает как извлечённые характеристики, так и исходное описание компонента. Его задача — сравнить структурированные характеристики с предоставленным описанием и определить, точно ли описание представляет идентифицированный компонент. Разделяя извлечение характеристик и проверку, система снижает сложность рассуждений и повышает согласованность решений по классификации.
По результатам сравнения второй агент ИИ возвращает одну из трёх заранее определённых инженерных классификаций:
• Match — описание правильно представляет компонент, идентифицированный артикулом производителя, и не содержит противоречащих характеристик. • Partial Match — описание не содержит противоречащей информации, но является неполным или требует дополнительных характеристик для соответствия стандартам инженерной документации. • No Match — одна или несколько характеристик, содержащихся в описании, противоречат характеристикам компонента, идентифицированного артикулом производителя.
Эти три классификации были определены в начале проекта и последовательно использовались на протяжении всего процесса разработки и проверки промптов. Для ряда проверочных случаев приемлемой считалась более чем одна классификация, поскольку описания могли обоснованно интерпретироваться по-разному без нарушения инженерного замысла. Поэтому методология проверки допускала заранее определённые альтернативные приемлемые результаты для отдельных тестовых случаев, что позволило объективно оценить разработанную систему ИИ.
Предлагаемое решение предназначено для работы в качестве инженерного ассистента, а не автономной системы принятия решений. Рабочий процесс ИИ выполняет задачу проверки и возвращает соответствующую классификацию, позволяя инженерам быстро выявлять записи BOM, требующие проверки или улучшения описания. При будущем промышленном внедрении этот рабочий процесс может быть интегрирован в существующее инженерное программное обеспечение, чтобы проверка стала частью обычного процесса подготовки BOM. В исходном предложении проекта интеграция с системами ERP/MRP указана как возможное будущее развитие за рамками данной проверки концепции.
Для поддержки практической разработки и оценки реализация проверки концепции была построена в среде автоматизации рабочих процессов, где оба агента ИИ работают последовательно в рамках единого оркестрируемого процесса. Проверочный набор данных, использованный для тестирования, хранился в структурированном формате электронной таблицы, что позволило систематически проводить эксперименты и сравнивать результаты. Кроме того, интерфейс Microsoft Excel использовался в качестве пользовательского инструмента, чтобы продемонстрировать, как инженеры могли бы взаимодействовать с системой в будущем сценарии внедрения. Эти инструменты использовались исключительно для прототипирования, тестирования и оценки и не являются обязательными компонентами итоговой производственной архитектуры.
Таким образом, предлагаемое решение состоит из двух тесно связанных компонентов рассуждения ИИ, работающих последовательно: первый агент отвечает за извлечение характеристик, а второй — за проверку и классификацию. Вместе они образуют структурированный рабочий процесс проверки на основе ИИ, обеспечивающий согласованную, масштабируемую и соответствующую инженерным требованиям оценку данных производственной мастер-спецификации.
Проектирование системы
Система была спроектирована как модульное решение для проверки с поддержкой ИИ, предназначенное для проверки соответствия между артикулами производителя (MPN) и соответствующими описаниями компонентов в производственных мастер-спецификациях материалов (BOM). Основной целью проектирования было создание масштабируемой методологии проверки, которая не опирается на вручную заданные наборы правил для отдельных категорий компонентов, а использует способности к рассуждению больших языковых моделей (LLM) для оценки технического соответствия между структурированными и неструктурированными инженерными данными.
Итоговый проект системы реализован как рабочий процесс ИИ из двух агентов, оркестрируемый с помощью платформы автоматизации n8n, которая обеспечивает структурированное выполнение последовательных шагов рассуждения, обмен по API с моделями LLM и обмен данными между компонентами системы. Такая конструкция на основе рабочего процесса обеспечивает воспроизводимость экспериментов и позволяет полностью контролировать выполнение промптов, выбор модели и регистрацию данных во время разработки и оценки.
Общая архитектура системы
Разработанная система проверки состоит из двух агентов ИИ, выполняемых последовательно в рамках единого автоматизированного рабочего процесса, реализованного в n8n. Рабочий процесс выступает центральным уровнем оркестрации, отвечающим за управление потоком данных между компонентами системы, инициирование вызовов API к LLM и хранение промежуточных и итоговых результатов.
Процесс проверки начинается, когда на вход подаются артикул производителя (MPN) и соответствующее описание компонента. Эти входные данные извлекаются из проверочного набора данных, хранящегося в Google Sheets, и передаются в рабочий процесс n8n для обработки.
Агент ИИ 1 — извлечение данных
Первый агент ИИ отвечает за получение и структурирование технических характеристик, связанных с предоставленным MPN. Его роль состоит не в проверке, а в поиске соответствующих и реальных характеристик в открытых источниках и преобразовании неструктурированной или полуструктурированной информации в стандартизированный формат характеристик.
Результатом работы этого агента является каноническое представление компонента, включающее ключевые технические атрибуты, такие как электрические, механические или функциональные свойства в зависимости от типа компонента. Этот структурированный результат служит эталонной базой для второго этапа системы.
Агент ИИ 2 — проверка описания
Второй агент ИИ получает два входа:
• Структурированные характеристики компонента, сформированные агентом ИИ 1 • Исходное описание компонента, представленное в наборе данных
Используя эти входные данные, агент выполняет смысловое и техническое сравнение извлечённых характеристик и предоставленного описания. Цель состоит в том, чтобы определить, точно ли описание отражает реальный компонент, определённый MPN.
По результатам этой оценки агент присваивает одну из трёх заранее определённых инженерных классификаций:
• Match — описание полностью соответствует извлечённым характеристикам. • Partial Match — описание в целом верно, но неполно или в нём отсутствуют ключевые атрибуты, требует улучшения. • No Match — описание содержит неверную или противоречивую техническую информацию.
Разделение системы на два независимых агента рассуждения значительно повысило надёжность, поскольку каждый агент выполняет одну чётко определённую задачу, а не совмещает поиск и проверку в одном шаге.
Выполнение рабочего процесса n8n и архитектура системы
Вся система из двух агентов реализована и выполняется с помощью платформы автоматизации рабочих процессов n8n, которая служит операционной основой прототипа.
Такая реализация на основе рабочего процесса обеспечивает полную прослеживаемость каждого эксперимента, включая версионирование промптов, конфигурацию модели, время выполнения и расход токенов. Она также позволяет быстро выполнять итерации в ходе разработки, поскольку изменения промптов или настроек модели можно вносить непосредственно в рабочем процессе без изменения базовой архитектуры системы.
Логика выполнения системы реализована в n8n и показана на рисунке 1.
Рисунок 1 — рабочий процесс n8n, реализующий систему проверки на основе ИИ из двух агентов
Рабочий процесс наглядно представляет полный конвейер выполнения, узел за узлом:
«Manual Trigger» — запускает выполнение при нажатии на него.
«Extract from Database» — получает пары «описание — артикул» из документа.
«Adjust the Input» — оставляет только пары «описание — артикул» для дальнейшей обработки.
«Pairs Loop» — перебирает в цикле пары «описание — артикул».
«Start Time» — фиксирует время начала выполнения.
«Data Extraction Agent» — получает техническую спецификацию компонента. 6.1. «OpenAI Model» — сама модель ИИ и её настройки для «Data Extraction Agent».
«Description Validating Agent» — сравнивает канонические характеристики от предыдущего агента с описанием и возвращает итоговую метку: Match | Partial Match | No Match. 7.1. «OpenAI Model2» — сама модель ИИ и её настройки для «Description Validating Agent».
«Finish Time» — выводит время выполнения.
«Parse the Info to Database» — записывает в базу данных итоговую метку и время выполнения. тестируемой системе автоматизации.
Такая реализация гарантирует, что теоретическая архитектура из двух агентов напрямую отображается на воспроизводимой и
Проверочный набор данных
Система опирается на структурированный проверочный набор данных, хранящийся в Google Sheets, который служит центральным хранилищем данных во время разработки и тестирования.
Каждая строка набора данных представляет один случай проверки, состоящий из артикула производителя и соответствующего описания компонента. Для поддержки оценки и отслеживания производительности включены дополнительные поля метаданных, как показано на рисунке 2.
Рисунок 2 — проверочный набор данных в Google Sheets, использованный для оценки системы
Ниже, в таблице 1, приведена разбивка по столбцам рисунка 2:
Таблица 1 — разбивка столбцов набора данных в Google Sheets
Столбец | Описание | ||||
MPN | Артикул производителя | ||||
Description | Входное описание, подлежащее проверке | ||||
Optimal Description | Эталонное инженерное описание | ||||
Desired Output | Ожидаемый результат классификации (может включать несколько допустимых меток) | ||||
Actual Output | Классификация, сформированная ИИ | ||||
Execution Time | Время обработки одного случая |
Набор данных (рисунок 2) был составлен так, чтобы включать широкий спектр случаев, в том числе:
• Полностью правильные описания • Частично полные описания • Неверные или противоречивые описания
Такое разнообразие гарантирует, что система оценивается по всем возможным результатам классификации и отражает реалистичные инженерные условия, встречающиеся в процессах проверки BOM.
Кроме того, некоторые записи набора данных содержат два допустимых значения «Desired Output». Это отражает тот факт, что некоторые описания компонентов могут быть интерпретированы более чем одним допустимым способом с инженерной точки зрения. В таких случаях обе классификации (например, Match и Partial Match) считаются допустимыми в зависимости от степени детализации интерпретации и стандартов документации. Такой подход был введён, чтобы обеспечить справедливую оценку системы ИИ в пограничных или неоднозначных случаях.
Пользовательский интерфейс
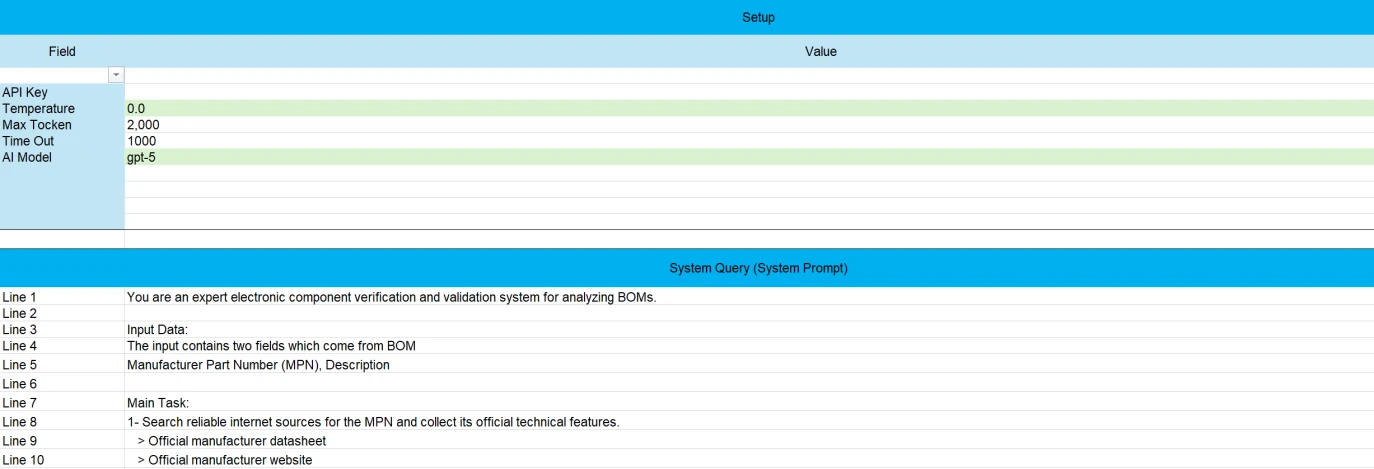
Для обеспечения практичного интерфейса взаимодействия с разработанным агентом проверки на основе ИИ было разработано специальное приложение Microsoft Excel. Книга служит не просто электронной таблицей: она содержит полноценную программу, реализованную с помощью макросов Excel, которая позволяет инженерам настраивать агента ИИ, запускать процесс проверки и просматривать сформированные классификации, не взаимодействуя напрямую с базовым рабочим процессом реализации.
Приложение состоит из двух основных листов — Settings и BOM, каждый из которых выполняет определённую роль в процессе проверки.
Лист Settings (см. рисунок 3) содержит настраиваемые параметры, необходимые для работы ИИ. Эти параметры определяют, как агент ИИ выполняет проверку, и включают:
• ключ OpenAI API; • выбор модели GPT; • максимальный лимит токенов; • тайм-аут запроса; • промпт проверки.
Все запросы на проверку, выполняемые через приложение, используют конфигурацию, заданную на этом листе. Такая конструкция позволяет инженерам менять модели ИИ, корректировать параметры выполнения или оценивать разные версии промптов без изменения базовой логики программы, что делает приложение пригодным как для экспериментальной оценки, так и для будущей настройки системы.
Рисунок 3 — лист Settings интерфейса проверки на основе ИИ в Excel.
Лист BOM (см. рисунок 4) служит основным рабочим интерфейсом. Он позволяет пользователю ввести артикул производителя и соответствующее описание компонента, которые будут проверены агентом ИИ. После ввода необходимых данных инженер запускает процесс проверки нажатием кнопки RUN. Затем приложение выполняет рабочий процесс проверки на основе ИИ с использованием настроек, указанных на листе Settings, и возвращает итоговую инженерную классификацию (Match, Partial Match или No Match) непосредственно в книге.
Рисунок 4 — лист BOM интерфейса проверки на основе ИИ в Excel.
На текущем этапе разработки приложение поддерживает проверку одной пары «MPN — описание» за один запуск. Поэтому при нажатии кнопки RUN обрабатывается только одна строка листа BOM. Это ограничение было признано приемлемым для реализации проверки концепции, поскольку основной целью проекта была проверка методологии проверки на основе ИИ, а не разработка готового к эксплуатации инженерного приложения. Дальнейшая разработка расширит приложение для поддержки пакетной обработки нескольких записей BOM, что позволит автоматически проверять полные производственные мастер-спецификации за один запуск.
Характеристики проекта
Предлагаемая система проверки на основе ИИ была спроектирована модульной, настраиваемой и масштабируемой. Благодаря разделению извлечения характеристик и проверки описания между двумя независимыми агентами ИИ процесс рассуждения становится более структурированным, а каждый агент можно оптимизировать независимо.
Система также настраивается через интерфейс Excel, где такие параметры, как модель GPT, промпт, максимальный лимит токенов и тайм-аут запроса, можно изменять без изменения базового приложения. Это поддерживает будущие эксперименты и адаптацию к новым моделям ИИ.
Наконец, хотя текущая проверка концепции проверяет одну пару «MPN — описание» за раз, общая конструкция создаёт основу для будущих улучшений, включая пакетную проверку полных производственных мастер-спецификаций и интеграцию с промышленными инженерными системами.
Реализация
Реализация предлагаемой системы проверки на основе ИИ следовала извлечённой методологии разработки, основанной на непрерывном экспериментировании и проектировании промптов. Вместо того чтобы спроектировать одного агента ИИ и оценить его производительность, систему последовательно улучшали в несколько этапов реализации. На каждом этапе вносились изменения в рабочий процесс, структуру промпта, стратегию рассуждения или модель ИИ, после чего обновлённая реализация оценивалась на том же проверочном наборе данных.
Прототип был разработан на платформе автоматизации рабочих процессов n8n, которая служила средой оркестрации и механизмом выполнения процесса проверки на основе ИИ. Рабочий процесс управлял получением данных, выполнением ИИ, обработкой ответов, измерением времени выполнения и хранением результатов, что позволяло оценивать каждое изменение реализации в одинаковых условиях. На протяжении всего проекта для хранения проверочного набора данных использовались Google Sheets, а разработанное приложение Microsoft Excel обеспечивало пользовательский интерфейс для настройки и запуска агента ИИ.
Реализация прототипа
Первоначальная реализация состояла из одного агента ИИ, отвечавшего за выполнение всего процесса проверки (см. рисунок 5). Во время выполнения рабочий процесс получал пару «MPN — описание» из проверочного набора данных, передавал её агенту ИИ вместе с промптом проверки, измерял время выполнения и сохранял возвращённую классификацию для дальнейшего анализа.
Рисунок 5 — первоначальный рабочий процесс n8n с 1 агентом
Рабочий процесс n8n автоматизировал весь экспериментальный процесс, гарантируя, что каждая версия промпта и каждая модель ИИ оценивались на одинаковых входных данных и в одинаковых условиях выполнения. Это исключило ручное вмешательство во время тестирования и обеспечило единообразную среду для сравнения результатов реализации.
Разработка промптов
В ходе реализации ключевыми направлениями были проектирование промптов и настройка поведения модели. Итеративные улучшения были направлены на уточнение инструкций, предоставляемых языковой моделью, и на контроль стабильности её ответов.
Первый промпт (см. рисунок 6) задал базовую методологию проверки, поручая ИИ извлечь характеристики компонента по артикулу производителя, сравнить их с предоставленным описанием и вернуть одну из трёх заранее определённых классификаций. Экспериментальная оценка показала, что эта реализация страдала тремя основными недостатками:
• неправильное форматирование вывода; • низкое качество рассуждений; • изменчивость ответов при повторных запусках.
Первая реализация промпта показала долю успешных результатов всего 18.75% с GPT-4o-mini и 34.375% с GPT-4o, что продемонстрировало необходимость существенной доработки промпта.
Рисунок 6 — первый промпт Рисунок 7 — восьмой промпт
Помимо изменения промптов, в ходе экспериментов систематически корректировался параметр температуры модели GPT-4o. Более низкие значения температуры использовались для повышения детерминированности и снижения вариативности результатов классификации, особенно в случаях, когда наблюдались несогласованные рассуждения. Эта настройка способствовала повышению стабильности результатов на более поздних этапах разработки.
Последующие версии промптов были направлены на постепенное улучшение процесса рассуждения. Внесённые изменения включали:
• замену неоднозначного состояния UNSURE на NOT STATED; • введение явной логики сравнения TRUE/FALSE/NOT STATED; • ужесточение ограничений формата вывода; • определение количественных правил принятия решения для Partial Match; • введение дополнительных правил рассуждения для снижения неоднозначности; • установку температуры выборки на ноль для повышения согласованности ответов.
Каждое изменение промпта оценивалось на полном проверочном наборе данных, прежде чем вносились дополнительные изменения. Этот итеративный процесс позволил объективно оценить влияние каждого решения по реализации.
В середине проекта мы достигли точности 96.875% с восьмым промптом (см. рисунок 7). Однако такая точность достигалась только в сочетании с моделью GPT-5, что делало использование слишком дорогим и значительно увеличивало время выполнения. Если с первым промптом среднее время обработки 1 пары «MPN — описание» моделью GPT-4o составляло ~1 с 346 мс, то с восьмым промптом на GPT-5 оно составило ~16 с 651 мс. Поэтому после этого работа над промптами была сосредоточена на создании промпта, который работал бы так же хорошо, как этот, но с более дешёвой и менее сложной моделью.
В итоге у нас было 2 промпта для 2 агентов ИИ: Data Extraction Agent и Description Validating Agent (см. рисунки 8.1 и 8.2).
Рисунок 8.1 — итоговый промпт (Data Extraction Agent) Рисунок 8.2 — итоговый промпт (Description Validating Agent)
Здесь Data Extraction Agent использовал модель GPT-4.1-mini, а Description Validating Agent — GPT-5.4-mini.
Экспериментальная оценка показала, что объединение извлечения характеристик и проверки описания в одном промпте часто приводило к неверным или неполным каноническим характеристикам, что затем влияло на итоговую классификацию. Разделение этих обязанностей между двумя специализированными агентами ИИ упростило рассуждения, выполняемые каждой моделью, и позволило оптимизировать обе задачи независимо. Это архитектурное изменение оказалось одним из наиболее значимых улучшений, внесённых в ходе реализации. Именно эта идея позволила нам достичь точности 96.875% с более дешёвыми и простыми моделями, сократив как стоимость, так и время выполнения, которое составило ~8 с 528 мс.
Оценка моделей ИИ
Оценка различных моделей ИИ проводилась не как отдельный этап после разработки промптов, а как неотъемлемая часть итеративного процесса оптимизации. На протяжении всей реализации структура промпта и выбранная модель GPT непрерывно корректировались и оценивались вместе, чтобы определить наиболее эффективное сочетание для задачи проверки.
В ходе разработки были исследованы несколько моделей OpenAI, включая GPT-4o-mini, GPT-4o, GPT-5, GPT-5.4-mini, а также гибридные конфигурации, сочетающие разные модели для извлечения характеристик и проверки. Каждая конфигурация тестировалась на одном и том же проверочном наборе данных, что позволяло напрямую сравнивать точность классификации, время выполнения, расход токенов и согласованность ответов.
На практике изменения промптов часто вносились в ответ на наблюдаемое поведение модели. Например, более слабые модели требовали более строго ограниченных промптов для снижения неоднозначности рассуждений, тогда как более сильные модели допускали более гибкую структуру инструкций. Аналогично, смена модели иногда производилась для компенсации ограничений, выявленных при тестировании промптов, таких как несогласованные рассуждения или недостаточное извлечение характеристик. Такая тесная связь между проектированием промптов и выбором модели была ключевой особенностью процесса разработки.
На более поздних экспериментальных этапах для отдельных конфигураций моделей также была включена функция веб-поиска, чтобы оценить, может ли получение внешней информации повысить точность характеристик. Хотя иногда это повышало
фактическую полноту, это также вносило вариативность в структуру ответов и увеличивало время выполнения, что снижало пригодность для контролируемого рабочего процесса проверки.
В целом эксперименты показали, что производительность модели и проектирование промптов сильно взаимозависимы. Хотя более продвинутые модели в целом улучшали качество рассуждений, итоговая производительность системы была достигнута только за счёт тщательного согласования возможностей модели с надлежащим образом структурированными промптами. Таким образом, проектирование промптов и выбор модели следует рассматривать как единую задачу оптимизации, а не как независимые шаги проектирования. Ниже см. таблицу 2, в которой показано, как менялись модели ИИ по мере улучшения промптов, и результаты этих изменений.
Таблица 2 — таблица результатов итеративных изменений промпта и модели ИИ
Промпт | Модель | Доля | ~Токены промпта | Среднее время | Примечания | ||
успеха | |||||||
Первый | Gpt-4o-mini | 18.75% | ~220 | ~1 с 373 мс | • Неправильная форма вывода • Слабые рассуждения | ||
Второй | Gpt-4o-mini | 25% | ~260 | ~1 с 285 мс | • Слабые рассуждения | ||
Первый | Gpt-4o | 34.375% | ~220 | ~1 с 346 мс | • Неправильная форма вывода • Слабые рассуждения • Изменчивые ответы | ||
Второй | Gpt-4o | 62.5% | ~280 | ~1 с 278 мс | • Слабые рассуждения | ||
Третий | Gpt-4o | 65.625% | ~280 | ~0 с 935 мс | • Слабые рассуждения | ||
Четвёртый | Gpt-4o | 71.875% | ~260 | ~1 с 231 мс | • Лучше, но всё ещё относительно слабые рассуждения • Даёт менее изменчивые ответы | ||
Пятый | Gpt-4o | 56.25% | ~340 | ~0 с 994 мс | • Ответ совсем не меняется • Слабые рассуждения | ||
Шестой | Gpt-4o | 59.375% | ~280 | ~1 с 169 мс | • Ответ совсем не меняется • Слабые рассуждения | ||
Шестой: с двойным Desired Output | Gpt-4o | 81.25% | ~280 | ~1 с 169 мс | • Ответ совсем не меняется • Слабые рассуждения | ||
Седьмой | Gpt-4o | 68.75% | ~330 | ~1 с 8 мс | • Слабые рассуждения | ||
Восьмой | Gpt-5 | 96.875% | ~280 | ~16 с 651 мс | • Слишком дорого • Слишком долго | ||
Девятый | Gpt-5.4-mini | 81.25% | ~380 | ~1 с 72 мс | • Работает строже • Лучше, но всё ещё относительно слабые решения | ||
Десятый | Gpt-5.4-mini | 84.375% | ~600 | ~2 с 674 мс | • Работает строже • Лучше, но всё ещё относительно слабые решения | ||
Одиннадцатый | 2 агента, gpt-5.4- mini | 81.25% | ~1900 | ~16 с 690 мс | • Слишком тяжёлое извлечение данных • Слишком долгое выполнение | ||
Двенадцатый | 2 агента, gpt-5.4- mini | 84.375% | ~580 | ~17 с 554 мс | • Слабые рассуждения • Слишком долгое выполнение |
Тринадцатый | 2 агента, gpt-5.4- mini | 96,875% | ~580 | ~9 с 286 мс | • Хорошие рассуждения • Дорого |
|---|---|---|---|---|---|
Тринадцатый | 2 агента: gpt-4.1- mini & gpt-5-mini | 96,875% | ~580 | ~8 с 528 мс | • Хорошие рассуждения |
Итоги реализации
Реализация эволюционировала от простого рабочего процесса проверки с одним агентом к модульной системе ИИ из двух агентов благодаря систематическому проектированию промптов и непрерывной экспериментальной оценке. Вместо того чтобы полагаться на отдельные изменения, каждое изменение реализации проверялось на одном и том же наборе данных и сравнивалось по количественным показателям производительности. Этот итеративный подход позволил постепенно улучшить качество рассуждений, согласованность ответов, время выполнения и вычислительную эффективность, что в итоге привело к надёжной проверке концепции, пригодной для проверки производственной мастер-спецификации с помощью ИИ.
Валидация и тестирование
Разработанная система проверки на основе ИИ была валидирована с помощью структурированной экспериментальной методологии, предназначенной для оценки как правильности сформированных классификаций, так и эксплуатационных характеристик реализованного решения. Каждое изменение реализации, включая изменения промптов, выбор модели ИИ и архитектурные улучшения, оценивалось на одном и том же проверочном наборе данных, что позволяло объективно сравнивать результаты разных этапов реализации.
Методология валидации
Процесс валидации основывался на заранее подготовленном наборе данных, состоящем из репрезентативных пар «артикул производителя (MPN) — описание компонента». Каждая запись включала ожидаемую инженерную классификацию, установленную до начала экспериментов, что позволяло сравнивать результаты, сформированные агентом проверки на основе ИИ, с желаемыми результатами.
Для ряда проверочных случаев правильными признавались две разные классификации. Эти случаи представляли описания, которые могли обоснованно интерпретироваться либо как Match, либо как Partial Match без нарушения заданных инженерных требований. Поэтому методология оценки считала допустимыми оба заранее определённых результата, обеспечивая, чтобы оценка отражала практическое инженерное суждение, а не навязывала излишне строгое детерминированное поведение.
Для повышения уверенности в полученных результатах каждая реализация запускалась дважды на полном проверочном наборе данных. Повторный запуск позволял не только измерить точность классификации, но и оценить согласованность ответов, выявляя, дают ли одинаковые входные данные одинаковые результаты в одних и тех же условиях выполнения.
Метрики валидации
Производительность каждой реализации оценивалась по четырём количественным метрикам.
Доля успешной классификации — процент проверочных записей, для которых сформированный результат совпал с одной из заранее определённых допустимых классификаций.
Время выполнения — среднее время, необходимое для проверки одной пары «MPN — описание», дающее представление о практической применимости разработанной системы.
Расход токенов промпта — приблизительное количество токенов промпта, обрабатываемых при каждом запуске. Поскольку взаимодействие с большими языковыми моделями напрямую влияет на эксплуатационные затраты, использование токенов отслеживалось на протяжении всего проекта как важная метрика оптимизации.
Согласованность ответов — оценивалось, дают ли повторные запуски на одном и том же проверочном наборе данных одинаковые классификации. Эта метрика была особенно важна на ранних этапах разработки промптов, когда некоторые модели ИИ демонстрировали недетерминированное поведение.
Экспериментальная оценка
Валидация проводилась непрерывно на протяжении всего процесса реализации. После каждого значимого изменения промпта, рабочего процесса или модели ИИ обрабатывался полный проверочный набор данных, а полученные метрики фиксировались.
В ходе экспериментальной оценки исследовались несколько аспектов разработанного решения, в том числе:
• сравнение различных моделей GPT; • влияние проектирования промптов на качество рассуждений; • влияние температуры выборки на согласованность ответов; • сравнение архитектур с одним и двумя агентами; • влияние размера промпта на время выполнения и расход токенов.
Использование одного и того же набора данных для каждого эксперимента гарантировало, что наблюдаемые различия в производительности были вызваны изменениями реализации, а не различиями в тестовых данных. Результаты итераций с разными моделями и промптами приведены выше в таблице 2.
Результаты валидации
Экспериментальные результаты демонстрируют явное улучшение на протяжении всего процесса реализации. Первоначальная реализация, основанная на одном агенте ИИ и первой версии промпта, достигла доли успешной классификации 18.75% с GPT-4o-mini и 34.375% с GPT-4o, что указывало на необходимость существенной доработки как проектирования промпта, так и методологии рассуждения.
Систематическое проектирование промптов, уточнение логики рассуждения, оценка нескольких моделей GPT и введение архитектуры из двух агентов постепенно улучшали производительность системы проверки. Итоговая реализация, использующая отдельные агенты извлечения данных (Data Extraction) и проверки описания (Description Validation) вместе с GPT-4.1-mini и GPT-5.4-mini, достигла точности валидации 96.875%, сократив размер промпта примерно до 580 токенов и требуя в среднем около 8.5 секунды на одну проверку.
Результаты также показывают, что одно лишь повышение возможностей модели не гарантировало улучшения общей производительности. Ряд промежуточных реализаций приводил к более высоким вычислительным затратам или более длительному времени выполнения без пропорционального повышения точности классификации. Наилучшая общая производительность была получена только после сочетания оптимизированных промптов, правильного выбора модели и методологии проверки с двумя агентами.
Итоги валидации
Процесс валидации подтвердил, что разработанная методология проверки на основе ИИ способна точно определять соответствие между артикулами производителя и описаниями компонентов на репрезентативном наборе инженерных примеров. Кроме того, экспериментальные результаты показывают, что систематическое проектирование промптов, тщательный выбор модели ИИ и архитектурная доработка могут значительно повысить как точность классификации, так и эксплуатационную эффективность. Достигнутая точность валидации 96.875% свидетельствует о том, что предлагаемый подход создаёт прочную основу для будущего промышленного внедрения и дальнейшего развития.
Соображения по внедрению
Хотя разработанная система проверки на основе ИИ была реализована в виде проверки концепции, её архитектура проектировалась с учётом будущего промышленного внедрения. Предлагаемое решение может быть интегрировано в существующие инженерные рабочие процессы, чтобы помогать инженерам при подготовке и проверке производственных мастер-спецификаций материалов (BOM), сокращая время ручной проверки и повышая согласованность описаний компонентов.
Практическое внедрение потребует интеграции с существующим инженерным программным обеспечением, таким как системы ERP, MRP или управления жизненным циклом изделия (PLM). Вместо ручного ввода артикулов производителя и описаний агент ИИ мог бы получать эту информацию непосредственно из инженерной базы данных организации и возвращать сформированную классификацию в соответствующую систему. Такая интеграция позволила бы выполнять автоматическую проверку при создании или пересмотре BOM без существенного изменения текущего инженерного рабочего процесса.
Поскольку разработанное решение опирается на большие языковые модели, доступ к которым осуществляется через OpenAI API, внедрение также требует надлежащего управления учётными данными API, сетевым подключением и правами доступа. Ключи API должны храниться и управляться безопасно, чтобы доступ к сервису проверки на основе ИИ имели только авторизованные пользователи и приложения.
Результаты валидации показывают, что разработанная система способна проверить одну пару «MPN — описание» примерно за 8.5 секунды при точности классификации 96.875%. Хотя такая производительность подходит для задач инженерной проверки, внедрение в крупных производственных средах может потребовать пакетной обработки, которая будет введена в будущем, для эффективной проверки полных производственных мастер-спецификаций, содержащих сотни или тысячи компонентов.
Модульная архитектура, принятая в ходе проекта, также поддерживает будущее сопровождение и развитие системы. Изменения моделей ИИ, проектирования промптов или критериев проверки можно реализовать без принципиального изменения общей методологии проверки. Такая гибкость позволяет системе адаптироваться к будущему развитию больших языковых моделей и меняющимся инженерным требованиям, сохраняя сложившийся рабочий процесс проверки.
В целом разработанная проверка концепции демонстрирует, что проверка артикулов производителя и описаний компонентов с помощью ИИ технически осуществима и создаёт практическую основу для будущего промышленного внедрения. Успешное внедрение будет зависеть прежде всего от интеграции с существующими инженерными системами, безопасного управления сервисами ИИ и дальнейшей оптимизации производительности для масштабных задач проверки.
Результаты и преимущества
Проект успешно продемонстрировал, что большие языковые модели могут применяться в качестве интеллектуальных инженерных ассистентов для проверки соответствия артикулов производителя (MPN) и описаний компонентов в производственных мастер-спецификациях материалов (BOM). Благодаря систематическому проектированию промптов, оценке моделей ИИ и архитектурной доработке разработанная проверка концепции эволюционировала от первоначальной реализации с ограниченной производительностью до надёжной системы проверки, способной достигать высокой точности классификации.
Результаты проекта
Одним из наиболее значимых итогов проекта стало повышение производительности классификации в ходе разработки. Первоначальная реализация с одним агентом показала долю успеха 18.75% с GPT-4o-mini и 34.375% с GPT-4o. Последовательные доработки промптов, оценка моделей и введение архитектуры из двух агентов постепенно повышали производительность системы. Итоговая реализация, состоящая из специализированных агента извлечения данных (Data Extraction Agent) и агента проверки описания (Description Validation Agent), достигла точности валидации 96.875% при среднем времени выполнения около 8.5 секунды на одну проверку и сокращении размера промпта примерно до 580 токенов.
Помимо количественных улучшений, проект продемонстрировал эффективность проектирования промптов как систематического процесса оптимизации. Вместо того чтобы полагаться исключительно на всё более мощные языковые модели, значительный прирост производительности был достигнут за счёт тщательной доработки структуры промпта, логики рассуждения и проектирования рабочего
процесса. Эксперименты подтвердили, что проектирование промптов оказывает существенное влияние как на точность классификации, так и на согласованность ответов.
Другим важным итогом стала разработка модульной методологии проверки с двумя агентами. Отделение извлечения характеристик от проверки описания упростило рассуждения каждого агента ИИ и позволило оптимизировать обе задачи независимо. Этот архитектурный подход оказался эффективнее первоначальной реализации с одним агентом и создаёт гибкую основу для будущих улучшений системы.
Таблица 3 — сравнение первоначальных и итоговых результатов
Показатель производительности | Начальное значение | Итоговое значение | ||||||
|---|---|---|---|---|---|---|---|---|
Архитектура | Один агент | Система из 2 агентов | ||||||
Модели ИИ | gpt-4o-mini/gpt-4o | gpt-4.1-mini + gpt-5.4-mini | ||||||
Точность классификации | 18.75–34.375% | 96.875% |
Кроме того, среднее время выполнения сократилось с ~16 с 651 мс до ~8 с 528 мс по сравнению с использованием восьмого промпта с моделью gpt-5, которая давала ту же долю успеха. Хотя текущая версия требует больше токенов промпта, чем восьмой промпт с gpt5, фактическая стоимость теперь ниже, поскольку используемые сейчас модели значительно дешевле. Таким образом, в ходе выполнения проекта мы значительно сократили время выполнения и стоимость без какой-либо потери точности.
Преимущества проекта
Разработанная система проверки на основе ИИ даёт ряд практических преимуществ инженерным организациям, отвечающим за ведение производственных мастер-спецификаций.
Во-первых, система сокращает объём ручного труда, необходимого для проверки описаний компонентов. Вместо того чтобы по отдельности сравнивать артикулы производителя с технической документацией, инженеры получают автоматическую оценку, показывающую, соответствует ли предоставленное описание указанному компоненту или требует дополнительной проверки. Это может значительно сократить время, затрачиваемое на однообразные действия по проверке.
Во-вторых, предлагаемая методология способствует большей согласованности инженерной документации. Применяя одну и ту же логику проверки к каждой паре «MPN — описание», агент ИИ уменьшает субъективные различия, которые могут возникать, когда ручную проверку выполняют несколько инженеров. Это способствует повышению качества и стандартизации данных BOM.
Проект также демонстрирует, что большие языковые модели могут успешно применяться в задачах инженерной проверки, требующих интерпретации технических характеристик, а не простого сопоставления ключевых слов. В отличие от традиционных систем проверки на основе правил, разработанное решение может рассуждать о самых разных описаниях компонентов без необходимости вручную задавать правила проверки для каждой категории компонентов.
Наконец, разработанная в ходе проекта модульная архитектура создаёт основу для будущего промышленного внедрения. Методология проверки на основе ИИ может быть интегрирована с существующим инженерным программным обеспечением и расширена для поддержки дополнительных функций проверки, более крупных наборов данных и пакетной обработки полных производственных мастер-спецификаций. Таким образом, проект закладывает практическую основу для будущих систем инженерной проверки с поддержкой ИИ в промышленной среде.
Трудности и извлечённые уроки
Разработка системы проверки на основе ИИ была связана с рядом технических и методологических трудностей, существенно повлиявших на итоговое решение. Преодоление этих трудностей требовало непрерывных экспериментов с
проектированием промптов, выбором модели ИИ, проектированием рабочего процесса и архитектурой системы. Уроки, извлечённые в ходе проекта, сыграли решающую роль в достижении итоговой реализации.
Трудности
Одной из основных трудностей, возникших в ходе проекта, было достижение надёжных и согласованных рассуждений ИИ. Хотя первоначальная реализация успешно задала рабочий процесс проверки, сформированные классификации часто были несогласованными и не всегда следовали заданной логике принятия решений. Повторные запуски иногда давали разные результаты для одинаковых входных данных, что делало систему непригодной для задач инженерной проверки, где воспроизводимость имеет решающее значение.
Ещё одной значительной трудностью было проектирование промптов. Разработка промптов, которые последовательно направляли бы языковую модель к правильной интерпретации технических характеристик, оказалась значительно сложнее, чем предполагалось изначально. Небольшие изменения формулировок промпта часто приводили к заметным изменениям качества сформированных классификаций. Поэтому разработка промптов превратилась в итеративный процесс оптимизации, требующий обширных экспериментов и объективной оценки.
Ещё одна сложность заключалась в том, чтобы сделать промпт достаточно строгим, структурированным и обобщаемым для работы с самыми разными компонентами при сохранении точности. Поскольку рамки проекта были намеренно широкими, система должна была обрабатывать очень разные типы изделий — от простых механических деталей до более сложных электронных компонентов. Это создавало противоречие между гибкостью и строгостью при проектировании промпта. Например, ранние версии промпта давали модели слишком большую свободу интерпретации, что приводило к случаям, когда резистор ошибочно подтверждался как конденсатор из-за чрезмерно обобщённых рассуждений. И наоборот, когда промпт делался слишком ограничительным за счёт чрезмерного акцента на конкретных ключевых словах или шаблонах, например требования точного совпадения терминов вроде «voltage rating» или «material type», система становилась менее адаптивной и не могла обобщать на компоненты, у которых эти атрибуты явно не указаны. Достижение баланса потребовало тщательного определения ключевых характеристик, универсально значимых для всех типов компонентов, без чрезмерного ограничения модели предположениями, специфичными для предметной области.
Дополнительная трудность возникла из-за надёжности внешних источников данных, используемых для извлечения характеристик. В ряде случаев разные авторитетные источники давали противоречивые или несогласованные технические значения для одного и того же артикула производителя. Это приводило к ситуациям, когда агент извлечения данных (Data Extraction Agent) получал неверные или неоднозначные характеристики, что затем влияло на итоговый результат проверки. Эти несоответствия были вызваны не самой моделью ИИ, а вариативностью исходных справочных данных. Хотя эта проблема была частично смягчена за счёт доработки промпта и логики перекрёстной проверки, она остаётся неотъемлемым ограничением опоры на различные внешние источники данных. Ожидается, что эта проблема будет дополнительно решена на будущих этапах проекта за счёт улучшенной приоритизации источников и механизмов оценки достоверности.
Выбор подходящих моделей ИИ также представлял трудность. На протяжении проекта оценивались несколько моделей GPT, чтобы определить наиболее подходящий баланс между способностью к рассуждению, временем выполнения и вычислительными затратами. Эксперименты показали, что более новые или более крупные языковые модели не обязательно дают лучшие результаты проверки. Вместо этого общая производительность зависела от взаимодействия выбранной модели, проектирования промпта и архитектуры рабочего процесса.
Переход от реализации с одним агентом к архитектуре с двумя агентами добавил сложности реализации. Разделение рабочего процесса на независимые агенты извлечения данных (Data Extraction) и проверки описания (Description Validation) потребовало переработки промптов, реструктуризации рабочего процесса и определения надёжного формата вывода информации для передачи между двумя этапами рассуждения. Однако в конечном счёте это архитектурное изменение стало одним из ключевых факторов значительного повышения точности проверки.
Извлечённые уроки
Проект показал, что проектирование промптов является фундаментальным аспектом разработки инженерных приложений с поддержкой ИИ. Качество инструкций, предоставляемых языковой модели, сильно влияло на производительность проверки, а результат оказался более чувствительным к незначительным изменениям промпта, чем ожидалось изначально, и систематическая доработка промптов оказалась необходимой для получения надёжных результатов.
Ещё один важный урок состоит в том, что эффективные системы ИИ должны по возможности разделять сложные задачи на более мелкие, чётко определённые шаги рассуждения. Отделение извлечения характеристик от проверки описания снизило
сложность, возлагаемую на каждого агента ИИ, упростило оптимизацию промптов и привело к существенно более точным и согласованным классификациям, чем исходный подход с одним агентом.
Проект также подчеркнул важность объективной экспериментальной оценки. Благодаря проверке каждого изменения реализации на одном и том же наборе данных и по заранее определённым критериям успеха улучшения можно было измерять количественно, а не полагаться на субъективные наблюдения. Эта итеративная методология позволяла принимать обоснованные инженерные решения на протяжении всего процесса разработки и гарантировала, что каждое изменение вносило положительный вклад в общую производительность системы.
Наконец, проект показал, что разработка инженерных инструментов на основе ИИ требует балансирования нескольких факторов производительности. Хотя итоговая реализация повлекла более высокие вычислительные затраты и более длительное время выполнения, чем первоначальный прототип, эти компромиссы были оправданы существенным повышением точности классификации и надёжности проверки. Этот опыт подчеркнул, что успешное проектирование систем ИИ должно рассматривать точность, согласованность, эффективность и практическую применимость как взаимодополняющие цели, а не оптимизировать одну метрику производительности.
Экономическое и промышленное значение
Хотя разработанная система проверки на основе ИИ в настоящее время является проверкой концепции, проект демонстрирует значительный потенциал применения в промышленной инженерной среде. Автоматизируя проверку соответствия артикулов производителя (MPN) и описаний компонентов, предлагаемое решение может повысить эффективность и качество подготовки производственной мастер-спецификации материалов (BOM), сокращая объём однообразной ручной проверки, выполняемой инженерами.
Разработанный агент ИИ предназначен для поддержки, а не замены принятия инженерных решений. Автоматически выявляя несогласованные, неполные или потенциально неверные описания, система позволяет инженерам сосредоточить внимание на записях, требующих проверки, вместо того чтобы вручную проверять каждую пару «MPN — описание». Такой подход может повысить производительность инженеров, особенно при работе с большими производственными мастер-спецификациями, содержащими сотни или тысячи компонентов.
Предлагаемая методология проверки также способствует большей согласованности инженерной документации. Поскольку каждая пара «MPN — описание» оценивается с помощью одного и того же процесса проверки на основе ИИ, субъективные различия между отдельными инженерами могут быть уменьшены, что приводит к более стандартизированным и надёжным описаниям компонентов. Более согласованные данные BOM могут улучшить взаимодействие между инженерными командами и снизить вероятность распространения ошибок документации на последующие этапы разработки и производства изделия.
С экономической точки зрения автоматизация однообразных действий по проверке может сократить инженерные трудозатраты на проверку BOM и уменьшить потребность в ручных переделках из-за несогласованных или неточных описаний. Хотя количественный анализ затрат и выгод не входил в рамки этого проекта, достигнутая точность проверки 96.875% показывает, что разработанная методология способна обеспечить надёжную инженерную поддержку, и создаёт прочную основу для оценки её экономического эффекта при будущем промышленном внедрении. Сокращение инженерных трудозатрат и экономия времени позволяют сократить время вывода нового продукта на рынок, тем самым способствуя повышению конкурентоспособности инженерной компании.
Другим важным итогом проекта является демонстрация того, что большие языковые модели могут успешно применяться в практических задачах инженерной проверки. В отличие от традиционных систем на основе правил, требующих вручную разработанных правил проверки для разных категорий компонентов, разработанный агент ИИ применяет универсальную методологию рассуждения, которую можно адаптировать к широкому спектру компонентов. Такая гибкость сокращает усилия, необходимые для расширения системы, и повышает её применимость в различных инженерных областях.
Наконец, модульная конструкция разработанного решения поддерживает будущую интеграцию с существующими инженерными программными средами, такими как системы ERP, MRP или управления жизненным циклом изделия (PLM). Вместе с настраиваемым интерфейсом Excel и методологией проверки на основе ИИ проект создаёт практическую основу для будущего промышленного внедрения и демонстрирует потенциал проверки с помощью ИИ для повышения эффективности, согласованности и качества управления производственными мастер-спецификациями.
Инновационность
Инновационность проекта заключается в применении больших языковых моделей (LLM) в качестве интеллектуальных инженерных ассистентов для проверки соответствия между артикулами производителя (MPN) и описаниями компонентов в производственных мастер-спецификациях материалов (BOM). Хотя LLM широко используются для общих разговорных задач, этот проект демонстрирует их применение к специализированной задаче инженерной проверки, которая традиционно опирается на ручную проверку и инженерный опыт.
Ключевой инновацией является разработка архитектуры проверки с двумя агентами. Вместо того чтобы поручать все задачи проверки одной модели ИИ, разработанная методология разделяет процесс между двумя специализированными агентами ИИ. Первый агент отвечает за извлечение канонических характеристик, связанных с артикулом производителя, а второй независимо проверяет предоставленное описание компонента на соответствие этим характеристикам. Такой модульный подход упрощает процесс рассуждения, повышает точность проверки и позволяет оптимизировать каждый этап независимо.
Ещё одним инновационным аспектом проекта является систематическое применение проектирования промптов как методологии инженерной оптимизации. Вместо того чтобы рассматривать промпты как статические инструкции, проект следовал итеративному процессу разработки, в котором изменения промптов проектировались, внедрялись и объективно оценивались на заранее подготовленном проверочном наборе данных. Этот структурированный подход показал, что тщательное проектирование промптов и архитектура рабочего процесса могут оказывать большее влияние на производительность системы, чем одна лишь смена базовой модели ИИ.
Наконец, проект демонстрирует практическую методологию интеграции ИИ в существующие инженерные рабочие процессы. Вместо замены инженерного суждения разработанная система функционирует как интеллектуальный инструмент поддержки принятия решений, помогающий инженерам автоматически выявлять несогласованные или неполные описания компонентов. Этот ориентированный на человека подход показывает, как ИИ может быть внедрён в промышленные инженерные процессы для повышения эффективности при сохранении контроля и ответственности инженера.
Выводы
В данном проекте исследовалось применение больших языковых моделей (LLM) для автоматизированной проверки соответствия артикулов производителя (MPN) и описаний компонентов в производственных мастер-спецификациях материалов (BOM). Основной целью была разработка агента проверки на основе ИИ, способного помогать инженерам, определяя, правильно ли предоставленное описание компонента соответствует компоненту, указанному его артикулом производителя.
Разработанное решение эволюционировало в ходе итеративного инженерного процесса, включавшего проектирование промптов, оценку нескольких моделей ИИ, доработку рабочего процесса и архитектурные улучшения. В итоговой реализации принята архитектура с двумя агентами, в которой один агент ИИ извлекает канонические характеристики компонента, а второй агент ИИ проверяет предоставленное описание на соответствие этим характеристикам. Этот подход значительно повысил надёжность и согласованность процесса проверки по сравнению с первоначальной реализацией с одним агентом.
Экспериментальная проверка показала, что итоговая система достигла точности классификации 96.875% на разработанном проверочном наборе данных. Проект также показал, что проектирование промптов и архитектура рабочего процесса существенно влияют на производительность системы и что тщательно спроектированные рабочие процессы ИИ могут обеспечить значительные улучшения, не полагаясь исключительно на всё более мощные языковые модели.
Помимо технических достижений, проект демонстрирует потенциал искусственного интеллекта для поддержки инженерной деятельности, традиционно требующей ручной проверки и экспертных знаний. Автоматизируя однообразные задачи проверки при сохранении участия инженеров в процессе принятия решений, разработанная методология создаёт практическую основу для будущей проверки производственных мастер-спецификаций с помощью ИИ.
В целом проект успешно достиг поставленных целей и показал, что большие языковые модели могут эффективно применяться в задачах инженерной проверки. Разработанная проверка концепции создаёт основу для дальнейших исследований и будущего промышленного внедрения, включая пакетную обработку полных BOM, интеграцию с существующим инженерным программным обеспечением и дальнейшую оптимизацию моделей ИИ и методологий проверки.
Будущие улучшения
Хотя разработанная система проверки на основе ИИ успешно демонстрирует осуществимость проверки соответствия артикулов производителя (MPN) и описаний компонентов с помощью ИИ, существует ряд возможностей для дальнейшего развития.
Одно из основных улучшений — расширение приложения Microsoft Excel для поддержки пакетной обработки нескольких пар «MPN — описание». Текущая проверка концепции проверяет одну запись за запуск, тогда как готовая к эксплуатации реализация должна автоматически обрабатывать полные производственные мастер-спецификации материалов (BOM), позволяя инженерам проверять сотни компонентов за одну операцию.
Ещё одно направление будущей работы — дальнейшая оптимизация рабочего процесса проверки на основе ИИ. Хотя итоговая реализация достигла точности классификации 96.875%, дальнейшие исследования могли бы изучить альтернативные стратегии проектирования промптов, более новые большие языковые модели и дополнительные оптимизации рабочего процесса для сокращения времени выполнения, расхода токенов и эксплуатационных затрат при сохранении или повышении точности проверки.
Проверочный набор данных также можно расширить, включив значительно большее количество пар «MPN — описание», представляющих более широкое разнообразие типов компонентов и стилей описаний. Более полный набор данных позволил бы шире оценить разработанную методологию и обеспечил бы большую уверенность в её производительности в различных инженерных применениях.
Ещё одно направление будущего развития — повышение надёжности процесса извлечения характеристик. На практике для одного и того же артикула производителя в технических паспортах производителя, каталогах дистрибьюторов и других доверенных технических источниках может быть доступна разная информация. Будущие исследования должны быть направлены на разработку методологии, которая выявляет и приоритизирует наиболее надёжную информацию до её использования для проверки. Это могло бы включать оценку нескольких доверенных источников, присвоение каждому источнику разного уровня достоверности и выбор наиболее точных характеристик. Такой подход повысил бы надёжность и строгость процесса проверки на основе ИИ, гарантируя, что проверка основана на наиболее заслуживающей доверия доступной технической информации.
Будущее развитие также должно быть сосредоточено на интеграции с промышленными инженерными системами. Вместо работы в качестве самостоятельного приложения методология проверки на основе ИИ могла бы быть встроена в системы ERP, MRP или управления жизненным циклом изделия (PLM), обеспечивая автоматическую проверку в процессах создания, изменения или утверждения BOM.
Наконец, важным улучшением стала бы возможность для системы формировать улучшенные описания компонентов при обнаружении результата «Partial Match». В таких случаях ИИ не только выявлял бы несоответствия, но и переписывал или уточнял описание, чтобы сделать его полностью соответствующим проверенным характеристикам. Это превратило бы систему из чисто проверочного инструмента в полуавтоматизированного ассистента по документации, помогающего инженерам эффективнее исправлять и стандартизировать записи BOM. Эти улучшения ещё больше расширили бы роль системы как комплексного инженерного инструмента с поддержкой ИИ для управления производственными мастер-спецификациями.
Приложения
Пошаговая разработка агента ИИ описана в файле ниже: https://docs.google.com/document/d/15FG3hX0K5stU9fB41bmJZ9hU0-MyUobprgoXJlrZqjE/edit?usp=sharing
Активы проекта
Практический пример «MPN — описание» находится в документе ниже: https://docs.google.com/spreadsheets/d/1xoq9UxTsZMycjPUqZesr9N1aT1dujryVbpAI2hhDfpc/edit?usp=sharing
Рабочий процесс n8n находится в файле json ниже — скопируйте и вставьте его в свой n8n:
Part Number Checking AI Agent __ YEA Engineering.json