Цель журнала — распространять знания, опыт и передовую практику в области инженерии и производства. Статьи пишут практикующие специалисты Engineering City (EC) в Ереване. Они освещают вопросы, связанные с их проектами, деятельностью и организациями. Статьи посвящены вызовам времени. Таким образом, журнал является также летописью развития EC, его компаний и людей. Цель журнала — развивать инженерную и производственную практику, обогащать инженерное и производственное сообщество и вносить вклад в мировой диалог в области инженерии и производства.
Издаётся Инженерной ассоциацией
The Engineering City JournalВыпуск 19/2025Издаётся Инженерной ассоциациейЕреван, 15 октября 2025 г.
Автор: Ashot Arzumanyan, ученик 11-го класса, стажёр в EC
Перевод на русский язык
Обработка файлов BOM при запуске нового проекта отнимает много времени и сил. Их нужно проверять на наличие всех данных, необходимых для успешного проведения этапа закупок. Поэтому и был начат этот проект.
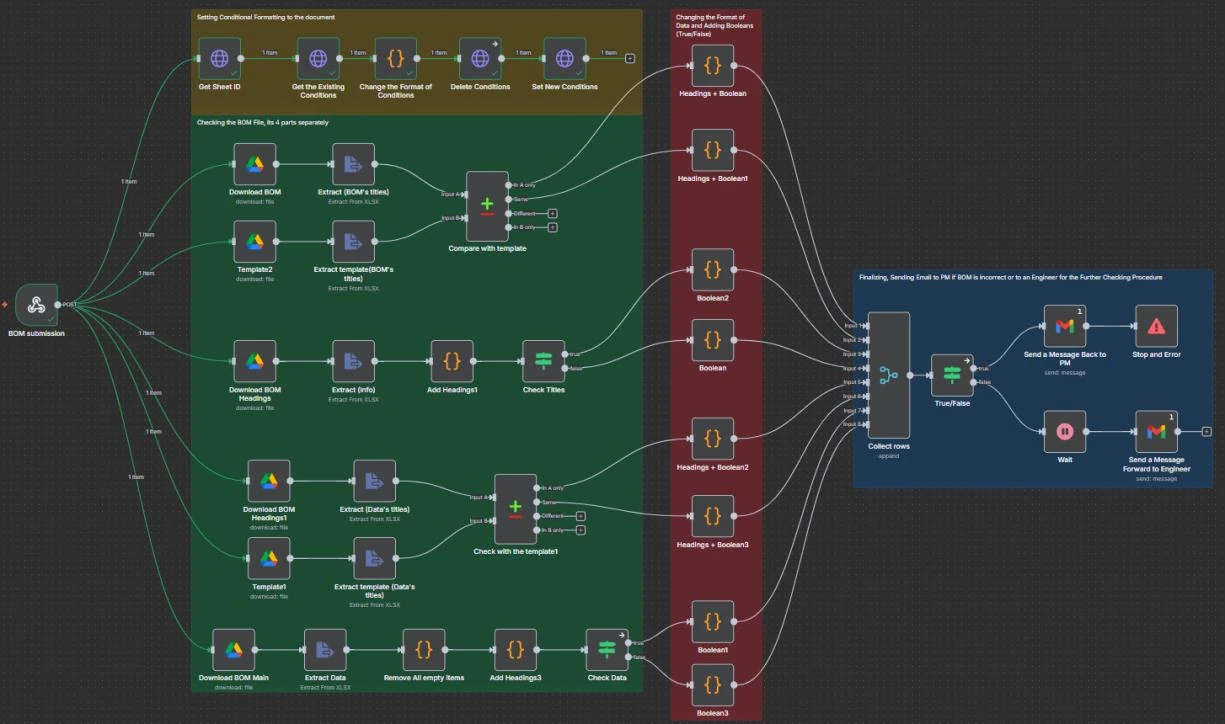
Ниже вы видите рабочий процесс, созданный в n8n, который автоматически проверяет, правильно ли структурирован BOM и соответствует ли он всем требованиям.
Рисунок 1– Рабочий процесс от начала до конца
Итак, начнём с триггера. Рабочий процесс запускается (приводится в действие определённым действием/условием) отправкой формы. Вы можете увидеть её ниже.
Рисунок 2 – Форма отправки BOM
Как только эта форма отправлена, рабочий процесс автоматически активируется. Он проверяет, соответствует ли отправленный BOM шаблону. Ниже вы видите шаблон (рисунок 3) и пример BOM (рисунок 4).
Рисунок 3 - ШаблонРисунок 4 - Пример отправленного BOM
Это делается в 4 этапа и разделено на 2 части (проверка шаблона и проверка данных):
Этап 1. Проверяются заголовки BOM (верхние 2 строки) (см. рисунок 5).
Этап 2. Проверяются заголовки столбцов данных (5-я и 6-я строки) (см. рисунок 6).
Затем рабочий процесс проверяет информацию внутри файла.
Этап 3. Проверяет, заполнены ли поля заголовков BOM и получены ли все необходимые данные (см. рисунок 7).
Этап 4. Проверяет, можно ли считать полными основные данные, где представлены компоненты BOM (см. рисунок 8).
Рисунок 7 – Полнота заголовков BOMРисунок 8 – Полнота основных данных
Все строки проверяются на то, что они не пусты (заполнены). Кроме того, некоторые поля должны быть заполнены в определённой форме, поэтому учитывались и эти условия. Например, Project ID должен начинаться с «PI-», а QTY должно быть числом. Если какое-либо поле пусто или не соответствует требованиям, BOM не пройдёт проверку.
После этого все позиции (строки документа) проходят процесс проверки; прошедшим присваивается значение true, а не прошедшие помечаются как false (обозначаются красным фоном (см. рисунок1)). Они собираются вместе и делятся на группы: true и false. Сначала выполняется ветвь false. Если есть позиции со значением false, руководителю проекта автоматически отправляется письмо, чтобы он устранил проблемы и повторно отправил BOM. Затем рабочий процесс останавливается (см. рисунок 9).
Если позиций со значением false нет, выполняется ветвь true, которая отправляет письмо инженеру, который должен подтвердить, что это правильный BOM (см. рисунок 9).
Рисунок 9 – Завершение рабочего процесса
Если всё верно, тем же письмом инженеру отправляется следующая форма:
Рисунок 10 – Форма подтверждения для инженера
Этот процесс обозначен синим цветом на рисунке 1.
Однако в большом файле BOM бывает трудно найти, где возникла проблема, чтобы её устранить. Поэтому этот рабочий процесс графически показывает проблемные ячейки, меняя их фон на красный.
Это делается в отдельной ветви (см. рисунок 11), в несколько шагов, с помощью HTTP-запросов к файлу BOM. Рабочий процесс автоматически получает ID таблицы и ID листа для доступа к файлу, затем удаляет все уже существующие условия и форматы, а следующим узлом задаёт новые, которые меняют цвет полей в документе.
Таким образом, благодаря этой функции руководителю проекта будет проще и быстрее увидеть, где возникла проблема, и устранить её.
Наконец, это лишь малая часть того, что следует автоматизировать. Однако даже эта крошечная автоматизация, вероятно, уже повысит производительность, результативность и эффективность процессов в YEA Engineering и будет способствовать её дальнейшему успеху.
Отраслевая система развития талантов (IB-TDS)
ИИ в инженерном образовании
Автор: Grigor Shirinyan, DigiCore
Перевод на русский язык
Введение
Контекст. Наши старшеклассники уже знают основы электроники, программирования и проектирования промптов. Вместо того чтобы использовать ИИ как машину для получения ответов, мы создали программу, в которой ИИ был партнёром в процессе работы двух групп:
Группа A — встраиваемое машинное обучение на ограниченном оборудовании.
Студенты развёртывают логику ML на платах Arduino (Uno, Nano, Pro, Mega) и ESP с очень разными характеристиками CPU/RAM/flash.
Группа B — локальный ИИ в мессенджерах. Студенты запускают частные локальные модели, ответы которых доставляются через ботов WhatsApp, Telegram и Viber.
Далее описан подход, а не только результаты. Он задуман как воспроизводимый и отличается от типичных описаний «ИИ в образовании»: мы оцениваем свидетельства процесса, настаиваем на объяснимости и используем ИИ для оптимизации алгоритмов, чтобы они могли эффективно работать на ограниченном оборудовании.
Принципы, которые мы используем
Тренер — тот, кто помогает понять, а не оракул. Тренер не сообщает факты; он учит тому, как разобраться в том, как что-то работает.
Правило 85%. Если студент понимает <85% того, что он создал, он должен с помощью ИИ получить объяснения, а затем объяснить механизм тренеру.
Политика «объясни, чтобы запустить». Код можно прошивать/развёртывать только вместе с краткой запиской о механизме: что он делает, почему подходит для устройства, как мы будем его проверять.
ИИ — итеративный процесс, а не один промпт. Студенты проходят путь: идея → варианты → выбор → реализация → отладка → осмысление.
По умолчанию — локально. По возможности модели работают локально/на устройстве; боты лишь передают сообщения.
Группа A — встраиваемое ML на Arduino/ESP
Проекты
Управление дорожным движением: объединение данных датчиков для переключения светофоров на основе реальных транспортных потоков.
Распознавание / классификация объектов: ограниченные конвейеры (например, на основе признаков или крошечные варианты CNN), рассчитанные на возможности микроконтроллера.
Статистика: скользящие средние, флаги аномалий и пороговая обработка для контроля состояния датчиков.
Используемые алгоритмы
Студенты экспериментировали с лёгкими алгоритмами машинного обучения, такими как логистическая регрессия, кластеризация k-средних и крошечные свёрточные нейронные сети (tiny CNN). Выбор зависел от
ограничений устройства: более простые алгоритмы — для плат с очень ограниченной памятью (Arduino Uno/Nano), и чуть более сложные — для более мощного оборудования, например плат ESP.
Порядок работы студентов:
Матрица выбора оборудования. С помощью ИИ студенты оценивают платы по RAM/flash, числу циклов на один вывод модели, задержке, энергопотреблению и поддержке библиотек. Они должны обосновать, почему Uno, Mega или ESP — и почему не другие.
Сборка и схемы. ИИ помогает набросать схемы и проверить на корректность распиновку, бюджет питания и защиту (резисторы, диоды).
Программирование.
Студенты сначала пишут код сами; ИИ используется для переноса (например, Python → C/C++ для Arduino) и проверки совместимости с инструментальными цепочками.
ИИ предлагает безопасные с точки зрения памяти правки (буферы, ограничения стека/кучи) и выявляет горячие циклы для микрооптимизаций.
Дневник отладки. Каждая загрузка требует короткой записи: симптом → гипотеза → тест → изменение → повторный тест.
Развёртывание и проверка. Студенты прикладывают данные о времени и памяти (например, время цикла, использование стека, FPS, задержку вывода) и простой отчёт о точности/ложных срабатываниях.
Чем это отличается: мы рассматриваем ограничения устройства как учителя. Студенты осваивают алгоритмические компромиссы (точность — задержка — память), потому что плата вынуждает вести этот разговор.
Группа B — локальный ИИ в WhatsApp/Telegram/Viber
Архитектура (эксплуатируется студентами)
Локальная модель (например, на лабораторном сервере) генерирует ответы.
Боты на каждой платформе отвечают за передачу; журналы по замыслу не содержат персональных данных.
Студенты реализуют ограничения частоты запросов, повторные попытки и базовый мониторинг.
Проблема обучения, которую мы увидели
Студенты, умеющие составлять промпты, могут быстро «найти» решения, но не всегда понимают, почему они работают. Наш ответ — структурированный многошаговый процесс с контрольными точками понимания:
Идея. Студенты просят у ИИ несколько подходов и перечисляют компромиссы.
Выбор. С помощью ИИ они выбирают наиболее подходящий путь (критерии: сложность, стоимость, конфиденциальность, сопровождаемость).
Реализация a. Библиотеки. Найти, установить и объяснить ключевые API.
b. Платформы и среды. Настроить интеграции с WhatsApp/Telegram/Viber. Задокументировать токены, вебхуки и безопасность c. Загрузка и запуск. Подключить бота к локальной модели. Пробный запуск с тестовыми пользователями.
d. Отладка с ИИ. Использовать модель для выдвижения гипотез, а не просто вставлять ошибки.
e. Документация. Подготовить блок-схему и краткое пояснение «как это работает».
f. Оптимизация. Профилировать время ответа и память; обрезать контекстные окна; кэшировать частые намерения. g. Мониторинг и откат. Базовые панели мониторинга, оповещения об ошибках и безопасные запасные варианты.
Чем это отличается: мы оцениваем артефакты объяснения (концептуальную карту, блок-схему) и операционную реальность (задержку, надёжность), а не только то, «отвечает» ли бот.
Оценивание, поощряющее подлинное понимание
Мы оцениваем не только то, «работает» ли проект. Вместо этого мы проверяем, насколько хорошо студенты понимают, что они сделали:
Работа над процессом (40%) — студенты должны показать пройденные шаги: матрицу выбора оборудования, дневник отладки, пояснительные записки и блок-схемы.
Устное объяснение (20%) — каждый студент делает короткое 3-минутное выступление (как мини-защита), во время которого тренер задаёт вопросы, проверяя понимание.
Производительность устройства (20%) — мы измеряем такие показатели, как использование памяти, скорость и точность на реальном оборудовании.
Надёжность системы (20%) — для проектов с мессенджерами мы проверяем, насколько хорошо работает система: быстро ли приходят ответы? Работают ли они в большинстве случаев? Справляется ли система с ошибками?
Студенты могут свободно пользоваться ИИ, но рассуждения должны быть их собственными. Если ИИ пишет код, студент его объясняет. Если ИИ даёт объяснение, студент проверяет и доказывает, что оно верно.
Чему мы научились (и в чём на самом деле состоит новизна)
От ответов к моделям. Студенты перестают спрашивать «Какой код?» и начинают спрашивать «Какая модель стоит за этим поведением?» — и для программного, и для аппаратного обеспечения.
Свобода работы с разными языками. Написание кода на знакомом языке и перенос с помощью ИИ на C/C++ для микроконтроллеров снижает страх перед низкоуровневой работой, сохраняя строгость.
Неудача становится данными. Дневник отладки делает нормой проверку гипотез вместо метода проб и ошибок.
Время тренера смещается к мышлению. Меньше лекций об API; больше наставничества по качеству решений и пониманию механизмов.
Риски и меры по их снижению
Чрезмерная зависимость от ИИ. Снижается политикой «объясни, чтобы запустить» и устной защитой.
Трудности оптимизации. Поначалу студентам может быть трудно сделать алгоритмы эффективными при ограниченной памяти и вычислительной мощности. Мы решаем это, направляя их к использованию ИИ для оптимизации кода и настройки производительности.
Безопасность оборудования. Ограничение тока, правильные шины питания и защитные компоненты не обсуждаются.
Поверхностная отладка. Критерии оценки дневника отладки наказывают за «заработало после вставки» без гипотез
Обучение за пределами запоминания (почему это важно)
Благодаря ИИ студенты научились не механически запоминать материал, а понимать и исследовать понятия, необходимые для их проектов. На этом этапе образования роль тренера — не просто объяснять
«как что-то работает» как факт, а направлять студентов к тому, чтобы они научились понимать, как всё устроено. Студенты, использующие ИИ в процессе обучения, становятся увереннее и самостоятельнее, а это качество очень ценно для будущих работодателей. Когда они пойдут на стажировку или придут в компании, наставникам и руководителям не придётся долго «кормить их с ложечки» — они уже будут способны самостоятельно учиться и решать задачи.
Почему старшая школа
Важно отметить, что такое применение ИИ логично и полезно для старшеклассников, а не для более младших учащихся. Прежде чем браться за проекты на основе ИИ, учащимся нужно сначала освоить основы электроники, программирования и решения задач. Только когда у них есть эта основа, ИИ может стать осмысленным инструментом — помогая проектировать, тестировать и оптимизировать, — а не коротким путём, заменяющим обучение.